
Introdução a Mensageria com RabbitMQ
Em algum momento você precisou processar algo complexo em um endpoint sem que o timeout estourasse, ou até mesmo um alto volume de dados para ser processados de tal modo a consumir muitos recursos computacionais, consultar diversos sistemas externos e etc. Nestes cenários, dentre vários outros, utilizar mensageria pode ser um caminho interessante para aumentar a tolerância a falhas, reduzir o consumo de recursos e também aumentar a disponibilidade das aplicações. No artigo de hoje, vamos falar um pouco sobre uma das ferramentas de mensageria mais utilizadas, o RabbitMQ.
Introdução
Algumas situações exigem que sejam realizado um processamento muito longe e/ou custoso para somente um endpoint realizar este processamento. Vamos imaginar uma situação: converter um vídeo do formato AVI (Audio Video Interleave) para MP4 (MPEG-4). Para videos pequenos, nós conseguimos realizar rapidamente no endpoint de uma API sem problemas, mas e se o vídeo tiver mais de 1GB de tamanho? Sem dúvidas demorará muito para ser processado e ocupará diversos recursos caso mais de uma chamada seja realizada ao mesmo tempo.
Pensando em outro cenário: um sistema de verificação de identidade, recebe os documentos do usuário e deve salvar estes documentos, executar um OCR (Optical Character Recognition) para a verificação dos dados, chamar diversos serviços que irão confirmar a identidade e veracidade dos documentos. Este é mais um cenário que o processamento dos dados pode demorar muito para ser realizado, além de ser mais suscetível a falhas devido as diversas chamadas a serviços externos sendo realizadas.
Ambos os cenários podemos receber uma mensagem (video no primeiro cenário e documentos no segundo) para processar. Devolver uma resposta do tipo “OK vou processar”, realizar o processamento utilizando mensageria e então enviar uma mensagem quando o processamento for concluído.
Sistemas assíncronos
Mensageria está comumente relacionada a sistemas assíncronos. Este tipo de sistema trabalha recebendo uma chamada, devolvendo uma resposta indicando que ainda será processado e posteriormente enviando uma notificação indicando que o processamento foi concluído.
Utilizando esta técnica é possível suportar uma alta carga de requisições sem a necessidade de adicionar muitos recursos para que a API realize os processamentos pesados logo na chamada de um endpoint. O processamento ocorre de forma assíncrona e podemos adicionar recursos para realiza-lo mais rapidamente somente quando necessário.
Para ficar mais claro, vamos utilizar o primeiro cenário para ilustrar um exemplo.
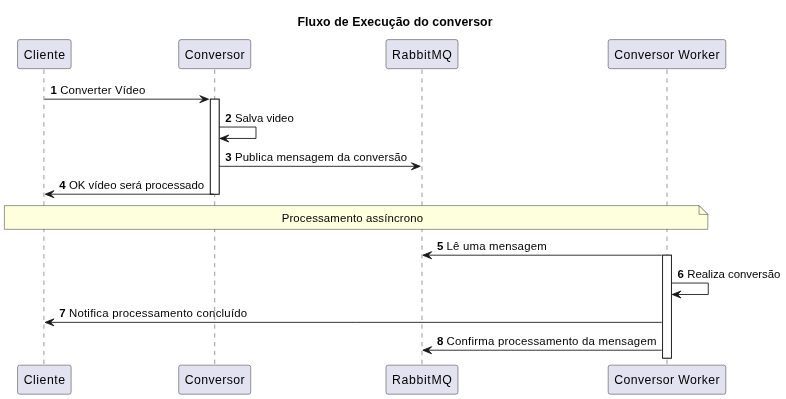
Fluxo de conversão utilizando mensageria
Uma aplicação cliente envia o vídeo para ser convertido, nossa aplicação recebe e salva este vídeo, adiciona uma mensagem na fila de processamento do RabbitMQ e retorna uma mensagem indicando que o processamento ainda vai ser realizado. Assincronamente, um worker receberá a mensagem e realizará a conversão do vídeo de AVI para MP4. Após a conclusão da conversão, o novo vídeo é salvo e uma notificação é disparada para o sistema que realizou a chamada.
O worker irá processar as mensagens a medida que forem sendo adicionadas na fila. Pode ser que em alguns momentos algumas se acumulem, mas assim que o worker finalizar o processamento de um vídeo ele irá executar imediatamente o próximo.
Como o RabbitMQ funciona?
Até agora falamos de forma genérica sobre como a mensageria funciona. Agora vamos aprofundar mais tecnicamente em como utilizar o RabbitMQ. Vou fazendo um funil de abstração para explicar o funcionamento do RabbitMQ.
Conceitualmente, quando estamos lidando com mensagens, estamos lidando com 3 papeis principais: Publishers (“publicadores”), Queues (filas) e Consumers/Subcribers (consumidores). Para que a comunicação e processamento ocorra, é necessário ter pelo menos um de cada papel no sistema computacional.
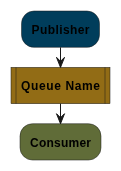
Publisher Consumer. Adaptado de: https://www.rabbitmq.com/tutorials/tutorial-one-python
Publishers, são sistemas que publicam as mensagens através de um Message Broker. O Message Broker irá receber esta mensagem e roteá-la (veremos sobre isto mais abaixo no artigo) para uma Queue que armazenará esta mensagem em ordem de chegada. O Consumer que estiver consumindo a fila, irá receber cada mensagem da fila para ser processada, ao final ele pode confirmar (ACK de Acknowledge) ou não confirmar (NACK de NotAcknowledge) a mensagem. Caso o consumo seja com sucesso (ACK) o Broker irá remover esta mensagem da fila e enviar a próxima mensagem. Então todo o ciclo de consumo se repete até não haver mais mensagens. Para o caso da não confirmação (NACK), ele irá enviar a mensagem para outro worker, caso haja, ou tentar enviar para o mesmo novamente.
As mensagens publicadas na fila são distribuídas respeitando a ordem de chegada, ou seja, a primeira mensagem a chegar, será a primeira mensagem a ser consumida por um worker. Também conhecido como FIFO (First In First Out). Mesmo sabendo que elas possuem uma ordem, é uma boa prática assumir que a ordem não será mantida caso existam múltiplos workers. Mesmo entregando as mensagens em ordem, um worker poderá finalizar o processamento antes de outros fazendo com que as mensagens não sejam exatamente processadas em ordem. Com um worker este comportamento não ocorre.
Ao se conectar no RabbitMQ, é criada uma conexão TCP para o Broker. Cada conexão deve possuir um ou mais canais de comunicação (são como conexões virtuais para o broker) que são usados para publicar/receber as mensagens em filas. Além dos canais, também são utilizados Exchanges que recebem as mensagens dos publishers realiza o roteamento destas mensagens para as filas.
Para publicar uma mensagem é necessário a mensagem propriamente dita e uma Rounting Key. De acordo com cada tipo de Exchange a Routing Key possui um significado diferente. Existem cinco tipos de exchanges no RabbitMQ:
- Direct: Este tipo exchange publica a mensagem direto na fila. Caso nenhum exchange seja criado ou utilizado, o Direct será utilizado automaticamente. Neste exchange, a Routing Key é utilizada contendo o nome exato da fila;
- Fanout: Este tipo exchange multiplica a mensagem em diversas filas, ou seja, uma única mensagem é enviada e uma copia é publicada uma ou mais filas que estejam associadas com este exchange. A Routing Key neste caso é o nome do exchange. Para criar este exchange, devemos fazer o Bind das filas nele, após este bind que ela irão começar a receber copias das mensagens publicadas;
- Headers: Este tipo de exchange publica mensagens baseadas no header da mensagem permitindo realizar um roteamento mais complexo da mensagem. Neste exchange a Routing Key é ignorada complemente, sendo utilizado somente os headers da mensagem enviada.
- Topics: Este tipo de exchange, roteia a mensagem baseado em um padrão entre a Routing Key e o bind em uma fila. Para ficar mais fácil de entender, podemos comparar com portais de noticias onde iremos nos inscrever para receber noticias de esportes em todas modalidades (“esportes.#”), noticias de futebol (“esportes.futebol.#”) ou noticias do Flamengo (“esportes.futebol.flamengo”). Ele pode publicar em uma ou mais filas a depender da configuração de bind de cada fila no exchange;
- x-local-random: Este tipo de exchange é desenhado para cenários onde é necessário processamento muito rápido. Ele garante que a mensagem vai ser enviada para uma fila local da instância do broker que recebeu a conexão (é possível conectar-se em um cluster de brokers), garantindo um tempo menor de latência para publicar. Nele é possível fazer o bind de múltiplas filas, neste caso, como o próprio nome diz, a mensagem será publicada aleatoriamente em uma destas filas. A Routing Key é o nome do exchange. Particularmente nunca utilizei este tipo de exchange, já passei por cenários que era necessário muito volume de publicações e/ou leituras, mas os demais exchanges já estavam com um desempenho bem satisfatório;
Após a mensagem ser enviada através do canal e ser roteada pelo exchange ela vai ser armazenada em uma Queue. Existem três tipos de filas e diversas configurações que podemos fazer e criar “novos” tipos de fila:
- Classic Queues: São filas mais comuns. Podem ser configuradas para serem persistentes ou transientes (sem persistência no disco). É o tipo de fila padrão do RabbitMQ. São leves e por isto é o mais recomendado para cenários que a latência deve ser baixa;
- Quorum Queues: São filas mais modernas. Este tipo de fila é recomendado para quando há a necessidade de uma alta disponibilidade dos dados pois os dados são replicados em diversos nós do cluster. São baseadas no algoritmo Raft Consensus;
- Stream Queues: São filas duráveis onde as mensagens adicionadas não são excluídas. Os consumidores podem consumir as mensagens e no futuro reprocessa-las já que elas não são excluídas. Quando um consumidor responde um ACK, um “ponteiro” move de posição dentro do Stream, ou seja, movendo o ponteiro para a posição zero é possível reprocessar todas as mensagens da fila de stream;
Quase todos (se não todos) tipos de fila possuem algumas configurações que mudam um pouco o comportamento delas, dando até a entender que são tipos novos de fila. Vou citar algumas configurações que podem ser feitas nas filas. Dependendo do problema a ser resolvido aplicar estas configurações pode ser muito vantajoso e também deixar o sistema mais robusto.
- Durable: Esta configuração diz se fila será durável, ou seja, caso o broker seja reiniciado a fila não será perdida. As mensagens são salvas no disco do computador quando esta configuração está ativada. Caso não esteja, a fila se torna transiente perdendo as mensagens assim que o broker for reiniciado. A fila transiente mantém todas as mensagens na memoria RAM.
- Max Priority: Esta configuração adiciona prioridades nas filas. A prioridade é como se fosse um “fura fila”. Se uma mensagem tiver a prioridade “2” (a prioridade máxima é definida por um número) e for publicado uma mensagem de prioridade “3”, a mensagem de prioridade 3 será processada antes da mensagem de prioridade “2”. Uma boa prática é não ter muitas prioridades, internamente a fila é “quebrada” em filas menores para cada prioridade, quanto mais prioridades possuir mais memória será consumida. Eu particularmente adiciono a prioridade máxima em “5” para poder dar um range maior de prioridades, onde a aplicação utiliza até a prioridade “4” e a “5” eu deixo reservado para necessidades de intervenção operacional;
- Message TTL: Tempo de vida da mensagem em milissegundos. Após o tempo se esgotar, a mensagem é deletada automaticamente da fila. Pode ser util em alguns cenários, mas nunca utilizei esta configuração nos projetos em que trabalhei;
- Max Length Bytes: Tamanho máximo do corpo da mensagem em bytes. Configuração que reforça boas práticas, não é muito interessante enviar mensagens longas para o RabbitMQ, primeiro que ela ocupa muito espaço para armazenar e segundo que o tempo de transferência pode adicionar um delay no processamento. Claro que vão existir cenários que não terá como fugir, para outros cenários, configurar um limite pode ser interessante;
Os consumidores se conectam, através de um canal, diretamente a uma fila para receber as mensagens enviadas. Sempre quando houver uma nova mensagem na fila ela é enviada para um dos consumidores conectados a fila. Ao se conectar a uma fila para processar as mensagens é possível escolher quantas mensagens serão recebidas a cada vez através da configuração Pre Fetch Count com a definição do número de mensagens que são recebidas de uma vez só. Algumas bibliotecas implementam valores padrões sendo dependente da implementação da biblioteca. Configurar um pré fetch de 20 mensagens, significa que toda vez que o consumidor for verificar por novas mensagens, até 20 serão enviadas. Desta forma podemos reduzir a quantidade de vezes que o consumidor vai no broker recuperar mensagens.
Não existe um número mágico para as mensagens de pré fetch, mas um número muito grande e um muito pequeno pode ser algo ruim. Buscando muitas mensagens consome mais rede para transmitir estas mensagens mas enquanto o worker processa estas mensagens a rede pode ficar ociosa. Um número muito pequeno causa uma alta utilização da rede para fins de buscar mais vezes por mensagens, não irá consumir tanto a rede pois cada mensagens pequena será rápida de ser transmitida porém o consumo será com conexões ocupadas buscando mensagens em curtos períodos de tempo. Normalmente utilizo o valor padrão da biblioteca que estou utilizando, raras vezes precisei trocar a quantidade.
Para ficar bem explicado sobre como o pré fetch funciona, vou levantar um cenário:
- Existe uma fila de pedidos de peças com 100 mensagens nela. Um worker vai começar a consumir as mensagens com 10 mensagens configuradas no pré fetch.
Este worker vai receber 10 mensagens de uma vez do RabbitMQ processando uma a uma. Restando 90 mensagens na fila que prontas para ser enviadas para outro worker ou novamente para o mesmo worker quando ele terminar de confirmar (ACK) ou não (NACK) as 10 mensagens.
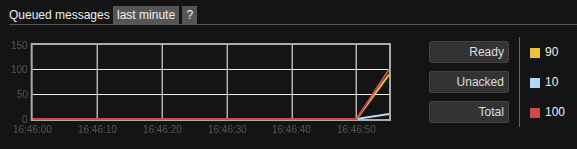
Fila com 100 mensagens e pre fetch de 10 mensagens
Dependendo da frequência e tamanho das mensagens, vale a pena configurar a quantidade de pré fetch do worker.
O RabbitMQ é um sistema muito robusto e além disso ele implementa alguns mecanismos para garantir a sua disponibilidade. Vou falar sobre o Wartermark este é um mecanismo em que a medida que o Host do RabbitMQ fica com recursos escassos, como a memória RAM por exemplo, ele ativa um alarme que não permite o envio de novas mensagens e bloqueia as conexões que estão enviando mensagens. A ideia deste alarme é garantir a saúde da aplicação, o envio será bloqueado até que o consumo das mensagens reduza a quantidade de memória utilizada pelo RabbitMQ. Quando o consumo cair abaixo do watermark, o envio volta ao normal automaticamente. Já tive um problema com isso e custou entender o porque as mensagens não estava sendo enviadas, estou falando sobre ele justamente para que caso ocorra contigo você possa investigar se o consumo das mensagens esta OK. Para saber mais confira este link.
Com isso cobrimos os principais conceitos do funcionamento do RabbitMQ. Neste artigo não vou abordar um exemplo, pois nos próximos quero trazer exemplos de cada tipo de fila e de consumo.
Vantagens e desvantagens de utilizar mensageria
Quando trabalhamos com broker de mensagens temos algumas vantagens e desvantagens. Não que seja ruim utiliza-los e possam dar muitos problemas, mas existem preocupações que devem ser consideradas para poder garantir o bom funcionamento tanto do Broker quanto da aplicação que está utilizando ele.
Vantagens
Trabalhando com mensageria trás algumas vantagens, muitas delas é por simplesmente utilizar um broker de mensagens. Vou listar algumas e explicar sobre elas:
- Comunicação Assíncrona. Produtores podem enviar as mensagens e imediatamente continuar com o trabalho sem a necessidade de esperar o processamento da mensagem. Isto aumenta a responsividade da aplicação;
- Baixo acoplamento. O sistemas não precisa se acoplar diretamente com outros sistemas, eles somente se acoplam com o broker de mensagens. Os sistemas da arquitetura podem ser atualizados e escalados independentemente dos demais;
- Escalabilidade e Balanceamento de Carga. Brokers de mensageria distribuem a carga entre múltiplos consumidores, permitindo a escalabilidade horizontal para gerenciar altos volumes de mensagens eficientemente;
- Resiliência e Confiabilidade. As mensagens são frequentemente persistidas em disco. Se um consumidor falhar, as mensagens são mantidas na fila até que o consumidor se recupere. Este comportamento também permite re-tentativas e garante que os dados não serão perdidos;
- Throughput Melhorado. Por causa do broker “bufferizar” as mensagens, a performance dos produtores não é reduzida por causa de consumidores lentos, permitindo assim um bom desempenho na média;
- Flexibilidade de Roteamento. Os brokers podem rotear as mensagens para consumidores específicos através de tópicos, tipos ou conteúdo. Permitindo um roteamento mais complexo quando necessário;
Desvantagens
Como sempre dizem: “Nem tudo são flores”. Temos algumas desvantagens também, mas estas desvantagens podem ser resolvidas sem muitos esforços. Também vou listar algumas e explicar sobre elas:
- Complexidade Operacional. Adicionar um broker também adiciona um novo componente que precisa de instalação, configuração, manutenção e monitoramento (exemplo: gerenciar filas, retenção de mensagens, throughput e etc) na arquitetura do sistema;
- Ponto Único de Falha. Se o broker falhar, a comunicação entre os sistemas será interrompida potencialmente causando a indisponibilidade de funcionalidades dos sistemas. Seu sistema precisa lidar com este tipo de situação;
- Consistência Eventual. Devido ao processamento ser assíncrono, os sistemas podem ter dados desatualizados até que as mensagens sejam processadas, levando a inconsistências temporárias;
- Dificuldade em Debbugar. Analisar uma requisição entre múltiplos serviços assíncronos para identificar causa raiz de um problema é bem complexo. É necessário verificar todos os produtores e consumidores que fazem parte do processamento da requisição para identificar o problema;
- Latência Aumentada. A mensagem precisa, sair do produtor até o broker, depois do broker até o consumidor. Isto adiciona um pouco de overhead em comparação da chamada direta a outro serviço;
- Lidando com Desafios. Garantir que a mensagem seja processada somente uma vez (sem processamentos duplicados) ou cenários que a mensagem é perdida requer uma configuração bem acertada das aplicações e do broker. OBS: Uma mensagem pode ser processada mais de uma vez quando o processamento do consumidor ocorre, mas após salvar tudo ele retorna um NACK para o broker. Desta forma o broker enviará a mensagem para outro consumidor processar e ele pode salvar novamente os dados;
- Curva de Aprendizado Elevada. Brokers diferentes possuem padrões diferentes que precisam de conhecimentos específicos para implementa-los apropriadamente. Conceitualmente são bem parecidos, mas a implementação não é tão parecida assim;
Conclusão
A utilização de brokers de mensagens auxilia na resolução de diversos problemas em um sistema, trazendo mais resiliência e tolerância a falhas. Além de aumentar além de aumentar o throughput em momentos de muita carga com a delegação de processamentos demorados e complexos para workers realizarem.
O RabbitMQ é um dos muitos brokers que existem no mercado. A vantagem de utilização é que ele é bem estável e conhecido, tornando fácil encontrar materiais a respeito de como utiliza-lo e configura-lo. Ele é bem completo, gratuito, open source, pode ser utilizado com diversos protocolos e permite diversos tipos de roteamentos complexos das mensagens enviadas. Particular eu gosto muito de utiliza-lo.
Como apresentamos ao longo do artigo, adicionar um broker de mensagens no seu sistema pode ser algo complexo por causa da necessidade de gerenciar o broker. Não é tão recomendado ter esta complexidade para sistemas pequenos. Apesar da alta resiliência do RabbitMQ, caso algum problema ocorra com o broker, o seu sistema como um todo irá parar devido ele ser o nó central da sua arquitetura. O impacto da indisponibilidade pode ser um pouco elevado.
Utilizar um broker de mensagens também envolve algumas preocupações com relação ao como a aplicação é desenhada. Dependendo do cenário a aplicação deverá ajustar o seu funcionamento para aproveitar o broker de mensagens adequadamente. Não é algo muito complexo de fazer, mas adiciona mais alguns componentes na arquitetura sendo necessário também tomar cuidados com eles.